
Открываете в Search Console отчёт «Индексирование страниц», а там сотни адресов в статусе «Просканирована, но пока не проиндексирована» или «Обнаружена, не проиндексирована». Проверять каждый URL через инструмент проверки бессмысленно: чаще всего за сотней адресов стоят три-четыре причины, и все они видны по шаблону URL. Ниже — порядок работы, который превращает длинный список в короткий план правок.
Что на самом деле лежит в выгрузке
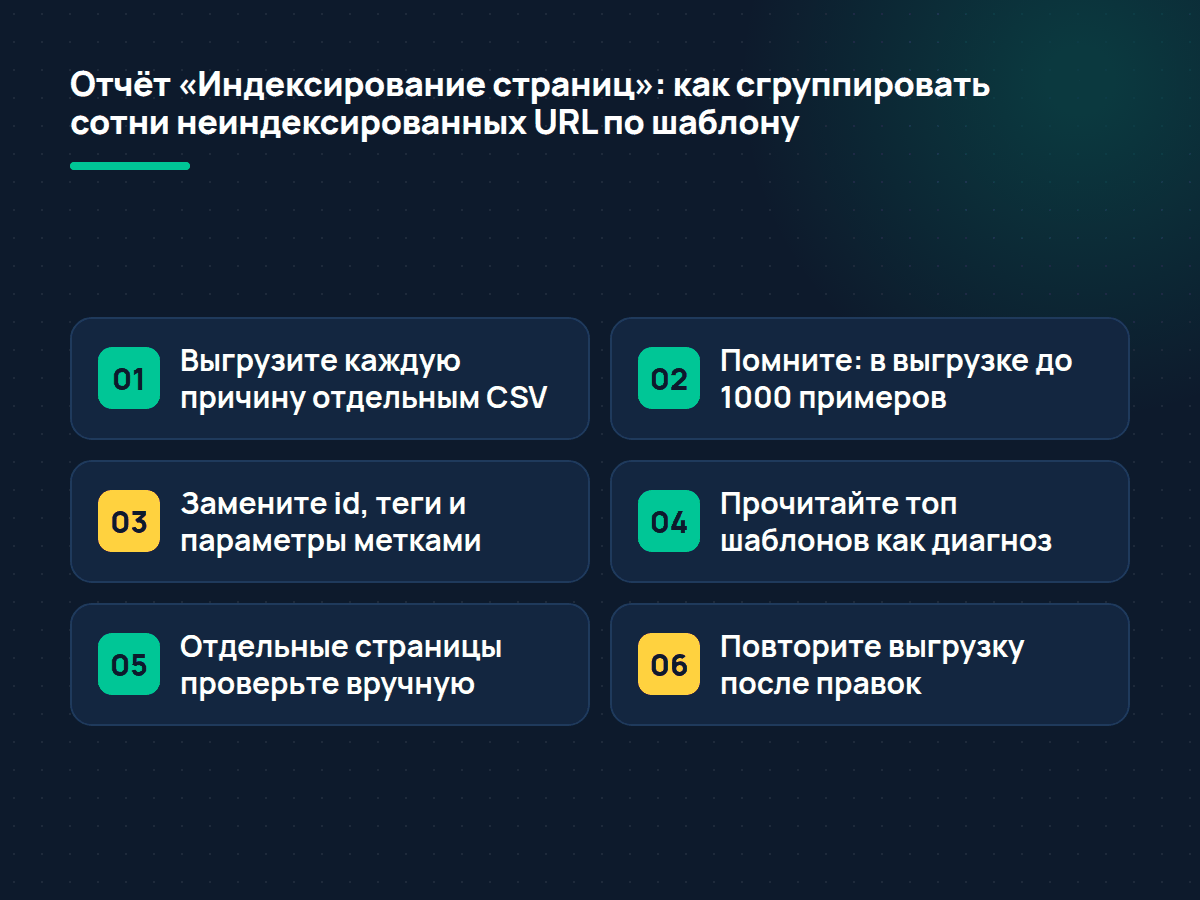
Отчёт показывает причины, по которым страницы не попали в индекс, и для каждой причины — таблицу примеров. Важно помнить два ограничения, о которых прямо пишет справка Google:
- список примеров ограничен 1000 строками и не гарантирует, что в нём есть все URL с этим статусом, даже если их меньше 1000;
- выгрузка из отчёта тоже обрезается до 1000 строк «репрезентативных примеров», а общие цифры на графике показывают полное количество.
Выгрузить таблицу можно в Google Таблицы, Excel или CSV. Получается, что CSV — это выборка, а не полный список. Поэтому задача не в том, чтобы «вылечить каждую строку», а в том, чтобы по выборке найти шаблоны, которые повторяются на всём сайте.
Шаг 1. Выгрузите каждую причину отдельно
Файл экспорта содержит только адреса и дату последнего сканирования — самой причины в нём нет. Если смешать в одной таблице «Страница с переадресацией» и «Просканирована, но пока не проиндексирована», потом не разберёшь, что к чему. Порядок такой:
- Откройте «Индексирование страниц» → блок «Почему эти страницы не индексируются».
- Кликните по причине, нажмите «Экспортировать» и выберите CSV.
- Назовите файл по причине:
crawled-not-indexed.csv,discovered-not-indexed.csv,duplicate-no-canonical.csv.
Если в причине больше тысячи адресов, переключите фильтр отчёта с «Все известные страницы» на конкретный файл Sitemap. Каждый фильтр даёт свою выборку примеров, поэтому раздельные Sitemap по разделам сайта (каталог, блог, теги) заметно расширяют картину.
Шаг 2. Сведите URL к шаблонам
Шаблон — это адрес, в котором переменные части заменены метками. Например:
| Исходный URL | Шаблон |
|---|---|
| /catalog/shoes/?color=red&page=3 | /catalog/{catalog}/?color&page |
| /blog/tag/seo-2026/ | /blog/tag/{tag}/ |
| /product/48213/reviews/ | /product/{id}/reviews/ |
| /search/?q=кроссовки | /search/?q |
Правила свёртки простые: числа превращаются в {id}, значения GET-параметров отбрасываются (остаются только их имена, по алфавиту), а сегмент после tag, category, author или catalog заменяется меткой раздела.
Вот короткий скрипт на Python, который делает это для CSV из Search Console:
import csv, re, sys
from collections import Counter
from urllib.parse import urlsplit, parse_qsl

def pattern(url):
    p = urlsplit(url)
    parts = [re.sub(r"^[0-9]+$", "{id}", s) for s in p.path.strip("/").split("/") if s]
    for i, s in enumerate(parts[:-1]):
        if s in {"tag", "category", "author", "catalog"}:
            parts[i + 1] = "{" + s + "}"
    keys = sorted({k for k, _ in parse_qsl(p.query, keep_blank_values=True)})
    return "/" + "/".join(parts) + ("/?" + "&".join(keys) if keys else "/")

rows = list(csv.reader(open(sys.argv[1], encoding="utf-8")))
urls = [r[0] for r in rows[1:] if r and r[0].startswith("http")]
for pat, n in Counter(pattern(u) for u in urls).most_common(20):
    print(f"{n:5}  {pat}")
Запуск: python3 patterns.py crawled-not-indexed.csv. На выходе — топ шаблонов с количеством адресов. Обычно первые три-пять строк покрывают большую часть выборки.
Если не хочется возиться со скриптом, ту же работу делает браузерный инструмент: можно загрузить CSV и сгруппировать неиндексированные URL по причине и шаблону — данные обрабатываются прямо в браузере и никуда не отправляются.
Шаг 3. Прочитайте шаблоны как диагноз
Каждый типичный шаблон подсказывает свою правку. Самые частые случаи:
- Пагинация и сортировки (
?page,?sort,?order). Это не ошибка сама по себе: Google решает, какие варианты списка показывать. Проверьте, что важные товары и статьи доступны по обычным ссылкам без параметров, а внутренние ссылки ведут на чистые адреса. - Фильтры каталога (
?color&size). Комбинаций фильтров тысячи, ценность у большинства нулевая. Уберите на них внутренние ссылки или закройте лишние комбинации, а под спрос оставьте отдельные посадочные страницы. - Теги и архивы (
/tag/{tag}/,/author/{author}/). Пустые или почти одинаковые архивы — классический случай «Просканирована, но пока не проиндексирована». Объедините слабые теги, добавьте вводный текст к полезным, а мусорные исключите из Sitemap. - Внутренний поиск (
/search/?q). Такие страницы не стоит открывать для индекса: закройте их и уберите из Sitemap. - Карточки с id (
/product/{id}/). Если в шаблон попали обычные карточки товаров, причина чаще в содержании: короткое описание, дубли от поставщика, нет отзывов и характеристик. Здесь поможет только доработка самих страниц.
Шаг 4. Отделите шаблоны от отдельных страниц
После группировки остаются адреса, которые не попали ни в один массовый шаблон: отдельные статьи, услуги, важные категории. Именно их стоит проверить вручную через инструмент проверки URL и, после исправлений, отправить на повторное сканирование. Для массовых шаблонов ручная отправка не нужна — правка шаблона сайта меняет сразу все такие страницы.
Короткий чек-лист для оставшихся страниц:
- страница отдаёт код 200 и не закрыта в robots.txt или тегом noindex;
- канонический адрес указывает на саму страницу;
- на страницу есть внутренние ссылки из меню, категорий или статей;
- текст отвечает на запрос и не повторяет соседние страницы.
Шаг 5. Проверьте результат
Когда шаблоны исправлены, в отчёте можно нажать «Проверить исправление» для конкретной причины: Google заново просканирует известные адреса с этой проблемой. Повторно нажимать кнопку до завершения проверки не нужно. Параллельно удобно контролировать отдельные важные адреса — например, проверить индексацию списка URL в Google и сравнить результат с выгрузкой до правок.
Повторяйте выгрузку и группировку после каждого заметного изменения. Если шаблон исчез из топа или его доля упала, правка сработала; если вырос новый — значит, сайт начал генерировать новый тип лишних страниц, и его лучше поймать сразу.
Частые вопросы
Почему в CSV меньше адресов, чем на графике? Потому что таблица примеров и выгрузка ограничены 1000 строками, а график показывает полное число страниц с этой причиной.
Нужно ли отправлять каждый URL на переобход? Нет. Массовые шаблоны исправляются правкой шаблона сайта, вручную стоит отправлять только отдельные важные страницы.
Можно ли объединить причины в одном файле? Лучше не надо: в выгрузке нет колонки с причиной, и после объединения уже не понять, к какому статусу относится адрес.
Источники: справка Google Search Console — отчёт «Индексирование страниц» и экспорт данных из отчётов.