
Статус «Обнаружена, не проиндексирована» в отчёте «Индексирование страниц» Google Search Console означает одно: Google знает адрес страницы, но робот её ещё не запрашивал. Справка Search Console объясняет причину прямо — сканирование отложено, потому что могло привести к чрезмерной нагрузке на сайт. Содержимое страницы Google при этом не читал, и качество текста здесь ни при чём.
Лечится статус не переписыванием страниц, а тремя вещами: сервером, который отвечает быстро и без ошибок, чистым sitemap с честными датами и внутренними ссылками, которые доводят робота до нужных URL за два-три клика. Всё остальное — запросы на индексирование, внешние ссылки, отправка списком — работает только поверх этой базы.
Ниже — определение статуса, четыре причины, по которым Google откладывает визит, семь шагов диагностики с наблюдаемым результатом на каждом и сравнение способов подтолкнуть обход.
Что стоит за словами «обнаружена» и «не проиндексирована»
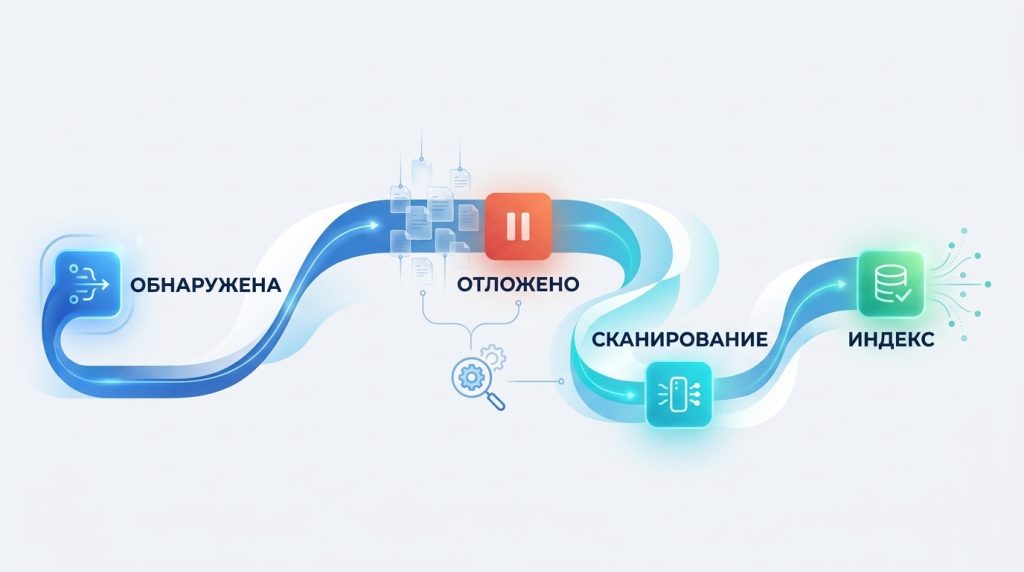
Индексирование в Google проходит в три этапа: обнаружение URL, сканирование и добавление в индекс.
Обнаружение — это момент, когда адрес попадает в очередь робота: из sitemap, по внутренней ссылке, по внешней ссылке или через запрос в инструменте проверки URL. Сканирование — запрос страницы роботом Googlebot и разбор ответа сервера. Индексирование — решение алгоритма хранить страницу и показывать её в поиске.
Статус «Обнаружена, не проиндексирована» описывает застревание между первой и второй стадиями. URL в очереди есть, запроса к серверу не было. Соседний статус «Страница просканирована, но пока не проиндексирована» — застревание между второй и третьей: робот страницу получил, а алгоритм её не взял. Разница принципиальная. В первом случае проблема в обходе, во втором — в содержании, и советы для одного статуса бесполезны для другого.
В третьем варианте — «URL неизвестен Google» в инструменте проверки URL. Это ещё раньше: адреса нет даже в очереди, потому что ни sitemap, ни ссылки до него не довели. Такой странице сначала нужно дать путь для обнаружения — ссылку или строку в sitemap, — и только потом разбираться, почему робот к ней не идёт.
Четыре причины, по которым Google откладывает обход
Документация Google по краулинговому бюджету раскладывает обход на две величины: предел скорости сканирования и потребность в сканировании. Первая — сколько запросов сайт выдерживает без ущерба для посетителей. Вторая — насколько Google хочет обходить именно этот сайт. Статус «Обнаружена, не проиндексирована» появляется, когда одна из величин мала, а очередь адресов длинная.
Медленный или падающий сервер. Google снижает предел скорости, когда время ответа растёт, а в ответах появляются коды 5xx и 429. Признак виден в Search Console на странице «Настройки → Статистика сканирования»: график среднего времени ответа ползёт вверх, в разбивке по кодам ответа заметна доля ошибок сервера, статус хоста показывает предупреждение. Робот при этом не уходит совсем — он приходит реже, и новые URL копятся в очереди.
Низкая потребность в обходе. Google охотнее сканирует сайты, чьи страницы он уже считает полезными, и реже — молодые домены, сайты с однотипными страницами и с историей тонкого контента. Признак — статус растёт равномерно по всем разделам, а не по одному шаблону URL, и держится месяцами при исправном сервере.
Очередь забита мусором. Фасеты, сортировки, параметры отслеживания, календари на десять лет вперёд — каждый такой адрес встаёт в ту же очередь, что карточка товара. Документация Google по краулинговому бюджету отдельно советует убирать дубли и адреса с идентичным содержимым именно потому, что они тратят обход впустую. Признак — в списке URL со статусом большинство адресов содержат «?», «sort=», «page=» или повторяют одну страницу с разными параметрами.
Страница далеко от точек входа. Googlebot идёт по ссылкам и выбирает, куда идти в первую очередь. Страница на шестом клике от главной, доступная только из пагинации или только из sitemap, ждёт дольше всех. Признак — у застрявших URL нет входящих внутренних ссылок из основного контента других страниц, только из футера или карты сайта.
Документация Google оговаривает, что управление краулинговым бюджетом нужно в первую очередь крупным сайтам — от десяти тысяч разных страниц с ежедневными изменениями или от миллиона страниц с еженедельными, — и прямо называет среди таких сайтов те, где большинство URL получили статус «Обнаружена, не проиндексирована». Цифры Google называет ориентировочными: магазин на три тысячи товаров с фасетами и сортировками легко генерирует сотни тысяч адресов и попадает в ту же категорию.
Семь шагов диагностики с проверяемым результатом
Шаг 1. Зафиксировать список и отделить свежие URL от застрявших.
В Search Console открыть «Индексирование → Страницы», в блоке «Почему страницы не индексируются» выбрать строку «Обнаружена, не проиндексирована» и экспортировать список URL. Рядом с каждым адресом — дата первого обнаружения из графика. Результат, который нужно увидеть: общее число URL и доля тех, что появились в списке меньше недели назад. Справка Search Console рекомендует выждать около недели, прежде чем что-то предпринимать. Если большинство адресов моложе семи дней, диагноз «проблема» ставить рано; если большая часть висит месяц и дольше — переходить к шагу 2.
Шаг 2. Проверить сервер по Статистике сканирования.
Открыть «Настройки → Статистика сканирования» за 90 дней и посмотреть три вещи: график «Среднее время ответа», разбивку «По ответу» и блок «Статус хоста». Смотреть сразу, затем повторять раз в неделю.
Удалось — время ответа стабильно ниже полусекунды без пиков (ориентир из практики, Google норму не публикует), доля кодов 5xx и 429 близка к нулю, все три индикатора статуса хоста без предупреждений.
Не удалось — рост времени ответа, всплеск 5xx, предупреждение о robots.txt или DNS. При провале любые действия по индексации откладываются: нужно стабилизировать хостинг, включить кэш для ботов, разгрузить тяжёлые шаблоны и перепроверить график через неделю. Недоступный robots.txt — отдельный случай: Google не сканирует сайт вовсе, пока не сможет прочитать файл.
Шаг 3. Выгрузить sitemap и проверить каждый URL в нём.
Открыть «Индексирование → Файлы Sitemap»: статус файла должен быть «Успешно», число обнаруженных URL — совпадать с ожидаемым, а лимиты — не больше 50 000 адресов и 50 МБ на файл по документации Google. Затем достать список адресов из файла: удобно извлечь URL из sitemap бесплатным инструментом и прогнать полученный список по кодам ответа.
Для единичной проверки — curl -I https://example.com/page/.
Удалось — каждый URL в файле отдаёт HTTP/2 200, не содержит noindex, а rel="canonical" указывает сам на себя.
Не удалось — в файле есть адреса с 301, 404, noindex или с canonical на другую страницу. Каждый такой адрес — потраченный слот обхода и минус к доверию ко всему файлу. Их убирают из sitemap, а не оставляют «на всякий случай».
Шаг 4. Проверить lastmod на честность.
Открыть сам XML и сравнить <lastmod> у нескольких страниц с реальной датой последней правки. Документация Google по sitemap говорит, что дата используется, когда она стабильно точна, и должна отражать последнее значимое изменение страницы; значения <priority> и <changefreq> Google игнорирует.
Удалось — у неизменённых страниц старая дата, у обновлённых — дата правки.
Не удалось — у всех URL одна и та же сегодняшняя дата, потому что CMS подставляет время генерации файла. Такой lastmod Google перестаёт учитывать, и sitemap превращается в простой список без сигнала приоритета. Исправление — отключить автообновление даты в плагине или генераторе и привязать <lastmod> к дате правки записи.
Шаг 5. Отсечь мусорные адреса от очереди.
В экспорте из шага 1 отфильтровать адреса по признакам «?», «sort=», «filter=», «page=», «utm_». Посчитать долю.
Удалось — параметрических URL меньшинство, основной объём статуса — реальные страницы.
Не удалось — большинство списка составляют параметры и фасеты. Тогда шаблоны закрывают в robots.txt директивой Disallow: /*?sort= и подобными, убирают из внутренних ссылок и из sitemap; проверяют результат через инструмент проверки robots.txt в Search Console. Индекс и очередь чистятся не за день — статус пересчитается через несколько недель, и это нормально.
Шаг 6. Довести внутренние ссылки до застрявших страниц.
Прогнать сайт сканером (Screaming Frog, Netpeak Spider) и посмотреть для URL из списка два столбца: глубину клика и число входящих внутренних ссылок.
Удалось — приоритетные страницы не глубже трёх кликов от главной и получают минимум одну ссылку из основного контента другой проиндексированной страницы.
Не удалось — глубина пять и больше, входящих ссылок ноль или только из футера. Исправление — ссылки из хабов, категорий и свежих статей, которые Google уже сканирует регулярно; в исходном HTML, а не в скрипте, который подгружает список после клика «Показать ещё». Проверить, что робот видит ссылку, можно по «Просканированной странице» в инструменте проверки URL.
Шаг 7. Запросить сканирование приоритетных страниц и измерить эффект.
Когда шаги 2–6 пройдены, для десятка самых важных URL открыть инструмент проверки URL и нажать «Запросить индексирование»; в интерфейсе появится подтверждение, что URL добавлен в приоритетную очередь. Проверять статус — через 7–14 дней, сравнивая с экспортом из шага 1. Удалось — число URL в статусе падает, приоритетные страницы перешли в «Проиндексировано».
Не удалось — статус не изменился при исправном сервере и чистом sitemap: значит, Google не видит причин обходить сайт чаще, и следующий шаг — внешние ссылки на хабы и сокращение числа однотипных страниц. Другой вариант неудачи — URL перешёл в «Страница просканирована, но пока не проиндексирована»: обход состоялся, дальше вопрос к содержанию, и это другой разбор.
Чем подтолкнуть обход: сравнение способов
| Способ | Кому подходит | Ожидаемая скорость | Риск | Когда не использовать |
|---|---|---|---|---|
| Запрос в инструменте проверки URL | Единичные приоритетные страницы | Часы — дни | Дневной лимит запросов; при живом 5xx запрос встаёт в ту же отложенную очередь | Для сотен URL и до исправления сервера |
| Sitemap с честным lastmod | Любой сайт с регулярными обновлениями | Дни — недели | Ложные даты обнуляют доверие ко всему файлу | Когда в файле есть 3xx, 4xx и noindex |
| Внутренние ссылки с хабов | Магазины, каталоги, крупные блоги | Дни — недели | Ссылки из скриптов и глубокой пагинации робот почти не использует | Когда хабы сами не в индексе |
| Внешние ссылки на разделы | Молодые домены с низкой потребностью в обходе | Недели | Спамные доноры не повышают доверие, а снижают | Как замена исправлению сервера и sitemap |
| Google Indexing API | Только страницы вакансий и трансляций | Часы | Для обычного контента нарушает условия использования | Для статей, карточек товаров, категорий |
| Отправка списком через сторонний сервис индексации | Сайты, где sitemap и ссылки уже в порядке, и чужие страницы без доступа к Search Console | 48–72 часа до первых результатов, отчёт на 7-й день | Визит робота на страницу с тонким содержанием заканчивается отказом алгоритма | Пока не исправлены 5xx и мусорные URL |
Ни один способ из таблицы не заставляет Google проиндексировать страницу: сервис или инструмент приводят робота, решение остаётся за алгоритмом. Разница между способами — в том, сколько URL и как быстро они доводят до сканирования.
Вопросы, которые остаются после чтения справки
В: Статус «Обнаружена, не проиндексирована» — это ошибка, которую нужно исправлять?
О: Сам по себе нет: справка Google описывает его как отложенное сканирование, а не как отказ. Исправлять нужно, когда статус держится дольше недели, растёт вместе с числом новых страниц или собирает приоритетные разделы сайта.
В: Почему Google откладывает сканирование, если сервер быстрый?
О: Второй множитель — потребность в обходе. Если сайт молодой, страницы однотипные или очередь забита параметрическими адресами, робот приходит редко даже к отзывчивому серверу. Признак — статус растёт по всем разделам равномерно.
В: Поможет ли повторная отправка sitemap в Search Console?
О: Повторная отправка того же файла не меняет очередь. Меняют её чистый список без 3xx, 4xx и noindex и честный lastmod, по которому Google видит, какие страницы обновились на самом деле.
В: Сколько ждать после запроса на индексирование в инструменте проверки URL?
О: Справка советует выждать около недели после обнаружения и только потом запрашивать сканирование приоритетных страниц. После запроса ориентир для проверки — 7–14 дней; ежедневные повторные запросы по одним и тем же адресам ничего не ускоряют.
В: Чем «Обнаружена, не проиндексирована» отличается от «Просканирована, но пока не проиндексирована»?
О: В первом случае робот на странице не был — вопрос к серверу, sitemap и ссылкам. Во втором был и отказал — вопрос к содержимому: тонкий текст, дубли, сирота без ссылок. Лечение разное, и переход из первого статуса во второй — уже прогресс.
В: Стоит ли закрывать фасеты и сортировки в robots.txt, если они уже в статусе?
О: Да, если они составляют большинство списка: Disallow по шаблону освобождает очередь для реальных страниц. Уже обнаруженные адреса из отчёта исчезнут не сразу — статус пересчитывается неделями.
Что изменится и что можно проверить за десять минут
Google в 2026 году по-прежнему принимает решение об обходе на основе нагрузки и потребности, и оба множителя описаны в его документации. Ожидать стоит не смягчения, а обратного: с ростом объёма автоматически сгенерированных страниц в вебе Google всё жёстче отсекает адреса без сигналов ценности, и очередь обнаруженных, но не просканированных URL у сайтов с фасетами и параметрами будет только расти. Сайты, которые держат sitemap чистым и доводят робота до страниц короткими путями, в этой очереди стоят первыми.
Проверка на десять минут: открыть «Настройки → Статистика сканирования» и посмотреть, растёт ли время ответа и есть ли 5xx; открыть «Индексирование → Файлы Sitemap» и убедиться, что статус «Успешно», а число URL совпадает с ожидаемым; выгрузить список из статуса «Обнаружена, не проиндексирована» и посчитать, какую долю в нём занимают адреса с «?». Три цифры покажут, с какого из семи шагов начинать.
Документация: управление краулинговым бюджетом для крупных сайтов.