
# X-Robots-Tag noindex для PDF файла: определение и применение
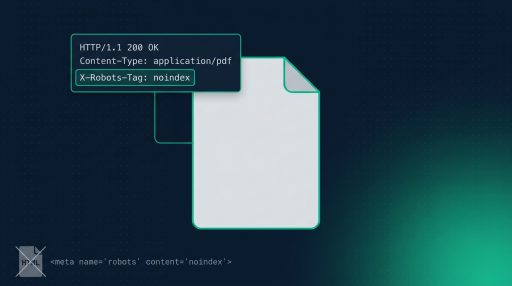
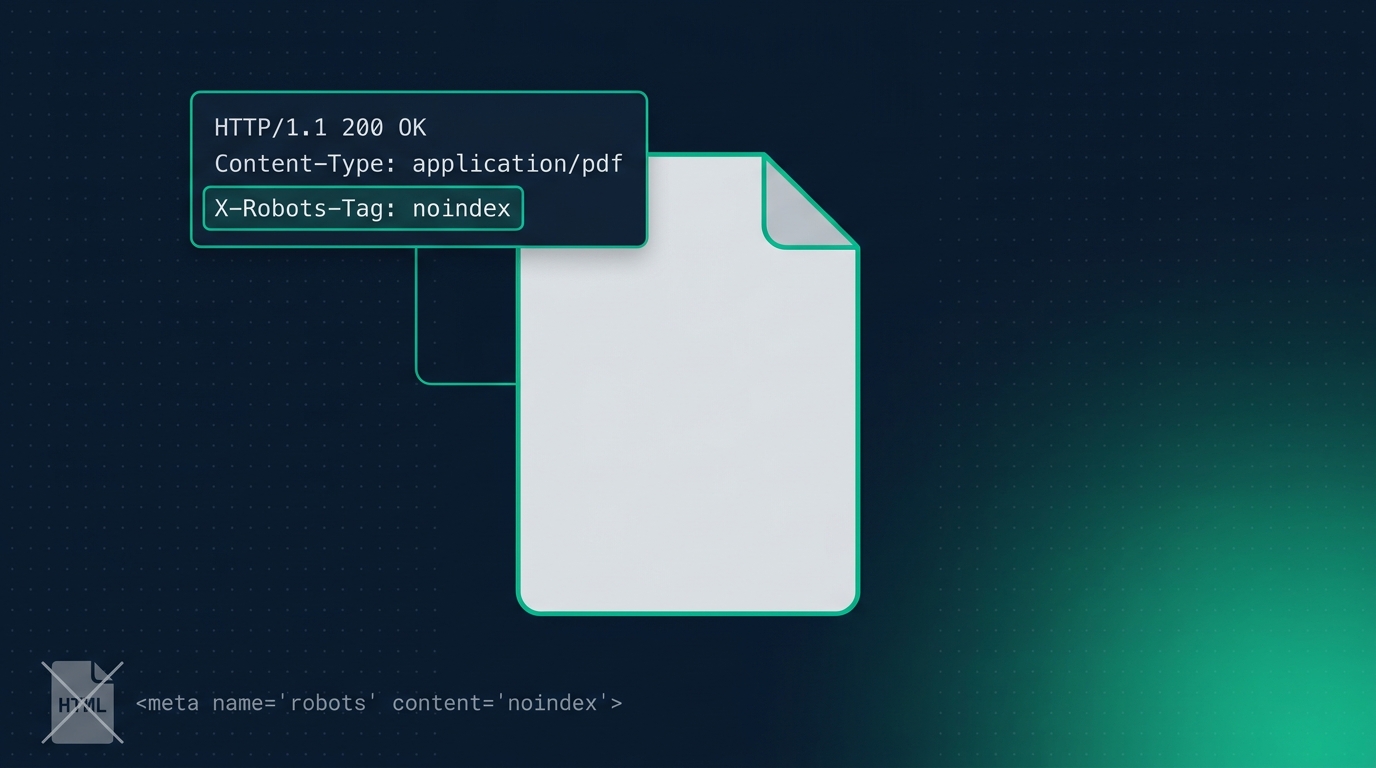
X-Robots-Tag noindex для PDF файла — это директива в HTTP-ответе сервера, которая предписывает поддерживающему её поисковому роботу не индексировать полученный ресурс. В отличие от HTML-метатега, она находится не внутри документа. Для PDF это принципиально: у него нет HTML-элемента «, в который можно корректно поместить «.
Основные определения
**X-Robots-Tag** — HTTP-заголовок, который передаёт поисковым роботам правила индексирования содержимого ответа. Он подходит для PDF, изображений и других ресурсов, не являющихся HTML.
**noindex** — значение, запрещающее включать ресурс в индекс. Чтобы прочитать эту директиву, робот должен иметь возможность запросить URL.
**robots.txt** — файл с правилами сканирования путей сайта. Запрет в нём регулирует получение ресурса роботом, но не равнозначен `noindex`.
**meta robots** — HTML-метатег, расположенный в « веб-страницы. Он применим к HTML, но не годится для управления отдельным PDF.
**canonical** — сигнал о предпочтительной версии среди одинаковых или очень похожих документов. Для PDF Google поддерживает передачу canonical через HTTP-заголовок `Link` с абсолютным URL.
## Как выглядит директива
Минимальный ответ сервера содержит строку:
«`text
X-Robots-Tag: noindex
«`
Её может добавлять конфигурация веб-сервера, CDN, прокси или хранилища файлов. Поэтому отсутствие соответствующей настройки в панели публикации ещё не доказывает, что заголовка нет. Проверять нужно реальный ответ по публичному адресу:
curl -I -L https://example.ru/docs/file.pdf
«`
Ключ `-L` заставляет curl следовать перенаправлениям. Оценивать следует конечный ответ, а при сложной конфигурации — всю цепочку. Полезно проверить статус, тип содержимого, `X-Robots-Tag` и `Link`.
## Сравнение способов управления
| Механизм | Где находится | Подходит для PDF | Что регулирует |
|—|—|—:|—|
| `X-Robots-Tag: noindex` | HTTP-ответ | Да | Индексирование ресурса |
| « | « HTML | Нет | Индексирование HTML-страницы || robots.txt | Отдельный файл сайта | Частично | Доступ робота к сканированию пути || `Link: ; rel=»canonical»` | HTTP-ответ | Да | Предпочтительную версию среди дублей |
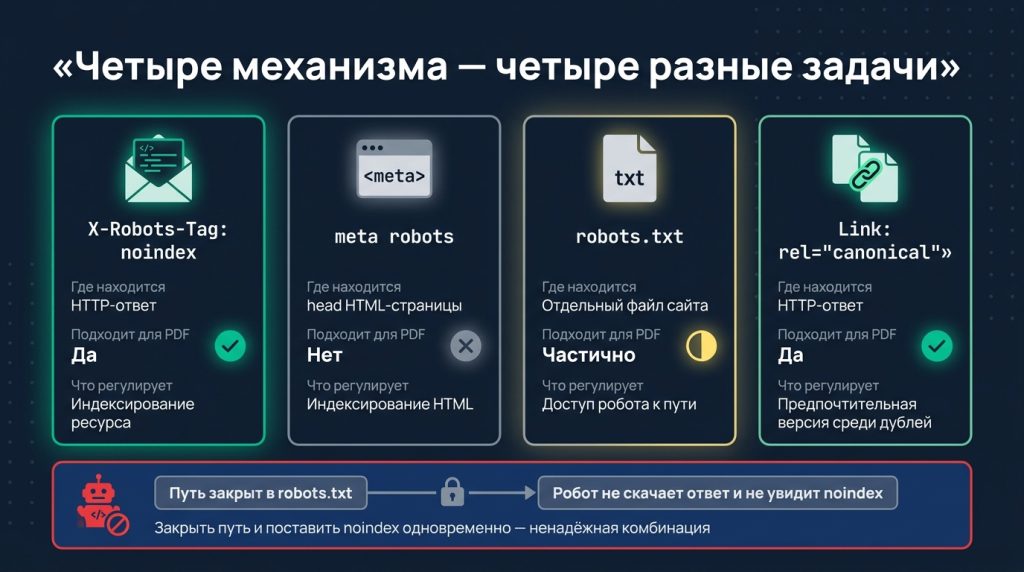
Главное различие между robots.txt и `noindex` связано с моментом обработки. Чтобы учесть заголовок `X-Robots-Tag`, поисковик должен скачать ответ. Если URL закрыт для сканирования в robots.txt, робот не сможет прочитать директиву, которая находится в ответе. Поэтому закрытие пути вместе с `noindex` не работает как надёжная комбинация для удаления известного PDF из поиска.
Различается и область действия. Правило robots.txt относится к сканированию указанного пути, тогда как HTTP-заголовок приходит вместе с конкретным ответом. Один сервер может отдавать разные заголовки для HTML и PDF или для разных каталогов. Поэтому проверка соседней страницы ничего не говорит о настройках файла: нужен запрос именно к его URL после всех перенаправлений.
При аудите также важно не путать отсутствие директивы с разрешением индексирования. Если `noindex` не найден, устранён только один возможный запрет. Это не подтверждает, что URL выбран каноническим, и не гарантирует включения ресурса в индекс.
## Когда noindex уместен
Директива уместна, когда файл должен открываться по прямой ссылке, но отдельно в поисковом индексе не нужен. Например, сайт публикует печатную версию материала, а главной точкой входа считает HTML-страницу. Это описание механизма, а не обещание, что известный URL сразу исчезнет из поиска: сначала робот должен заново получить файл и обработать обновлённый ответ.
Если PDF должен оставаться индексируемым, проверьте отсутствие `noindex`. После этого остаются другие условия. Google индексирует текстовые PDF, а для сканов может использовать OCR. Пароль и шифрование, как правило, препятствуют извлечению содержимого. По данным справки Яндекса, он индексирует PDF размером не более 10 МБ при наличии текстового слоя; в PDF, состоящем только из изображений, распознаётся текст первых трёх страниц. Яндекс также поддерживает `X-Robots-Tag`.
## Особенности обработки PDF
Индексируемость формата и разрешение конкретного URL — разные понятия. Поддержка PDF означает, что система технически умеет извлекать содержимое подходящего файла. Заголовок `noindex` действует на конкретный ответ и запрещает включение ресурса при любом качестве текста.
Чтобы проверить обычный текстовый PDF, попробуйте выделить и скопировать несколько фрагментов. Так можно обнаружить файл, который выглядит как текст, а на деле состоит из изображений. Для Google отдельным препятствием служат пароль и шифрование. Для Яндекса дополнительно сверьте ограничение размера и помните, что документы без текстового слоя обрабатываются иначе. Эти проверки не заменяют анализ заголовков: даже технически безупречный файл останется закрытым, если в ответе есть `noindex`.
## Noindex и canonical решают разные задачи
`noindex` запрещает индексирование URL. Canonical, напротив, сообщает, какой адрес предпочтителен среди дублей. Эти механизмы нельзя считать взаимозаменяемыми.
Для PDF Google принимает canonical в серверном заголовке:
«`text
Link: <https://example.ru/docs/main.pdf>; rel=»canonical»
«`
URL должен быть абсолютным. Если PDF повторяет HTML-материал, заголовок может указывать на абсолютный адрес HTML-версии. Такой сигнал применяют к одинаковому или очень близкому содержанию, а не к произвольной странице. Google рассматривает canonical как один из сигналов и может выбрать другую версию.
Яндекс тоже описывает HTTP-заголовок `Link` как способ указать канонический адрес документа. Важна согласованность: внутренние ссылки и другие сигналы не должны одновременно продвигать другой дубль.
## Порядок проверки
1. Запросить точный публичный URL с переходом по редиректам.
2. Убедиться, что конечный ответ действительно отдаёт PDF.
3. Найти все значения `X-Robots-Tag`, включая правила для конкретных роботов.
4. Проверить robots.txt: разрешено ли роботу получить ответ и прочитать директиву.
5. Проверить наличие пароля, шифрования и извлекаемого текстового слоя.
6. Если есть дубли, изучить HTTP-заголовок `Link` и абсолютный canonical.
7. Согласовать предпочтительный URL с внутренними ссылками.
Связанные причины подробнее разобраны в блоге [SpeedyIndex](https://blog.speedyindex.com/indeksatsiya-v-google/pochemu-pdf-ne-indeksiruetsya-v-google-i-yandekse-polnyj-razbor-prichin/). Если после проверки заголовков нужна общая картина, посмотрите [типичные ошибки индексации и как их избежать](https://speedyindex.com/oshibki-indeksatsii-kak-ikh-izbezhat/): они не отменяют запрета в HTTP-ответе, поэтому его нужно исправлять отдельно.
## FAQ
### Можно ли прописать meta robots внутри PDF?
Нет. Meta robots — элемент HTML. Чтобы передать директиву `noindex` вместе с PDF, используют HTTP-заголовок `X-Robots-Tag`.
### Почему нельзя просто запретить PDF в robots.txt?
Запрет в robots.txt препятствует сканированию. В результате робот может не увидеть HTTP-заголовок `X-Robots-Tag`, который доступен только при запросе ресурса.
### Достаточно ли убрать noindex, чтобы файл появился в поиске?
Нет. Удаление директивы снимает конкретный запрет, но не гарантирует включения. На обработку также влияют доступность файла, возможность извлечь текст и выбор канонической версии.
## ИСТОЧНИКИ